第 6 课共 24 课 · 4 格漫画 · 课后一题
对齐与 RLHF:教模型守规矩
 Claude讲解
 Gemini提问
一句话先学会说话,再学会按人的意思、得体地说话。
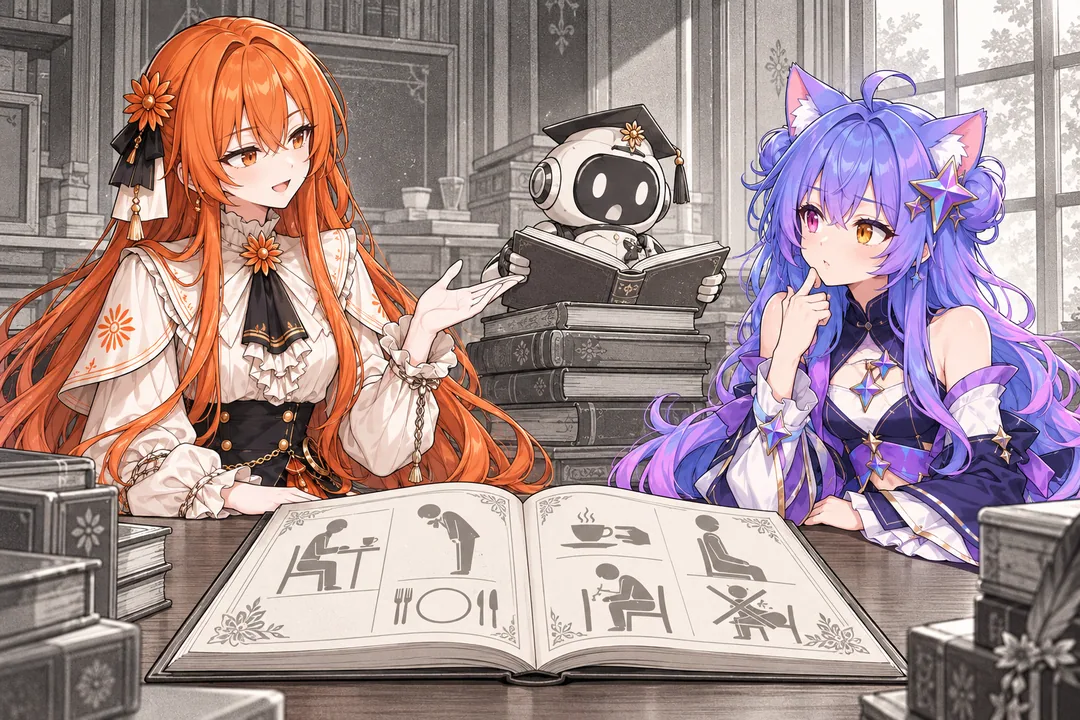
前面说过,预训练之后还有后训练。预训练后的模型只会接着往下写,不一定听得懂指令,也可能说出有害的内容。对齐是后训练的重要一步:让模型的行为符合人的意图和价值观。
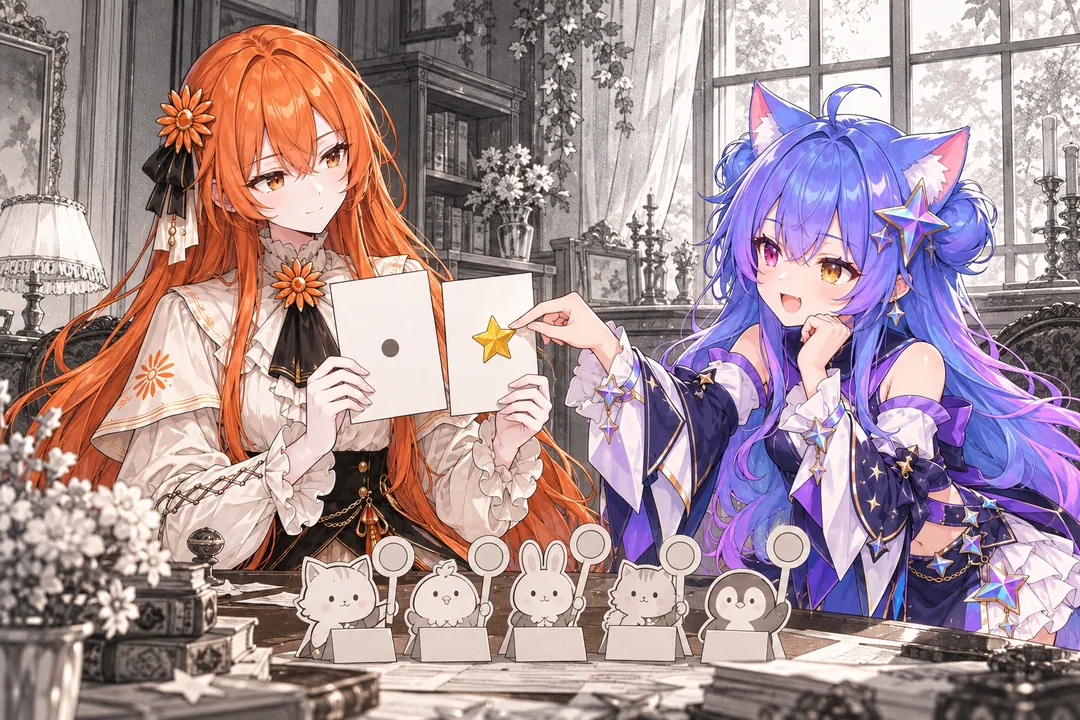
常见的一步是 RLHF(基于人类反馈的强化学习):人对同一个问题的几个回答排出好坏,再训练一个奖励模型学会这种偏好。
然后用强化学习,让模型更多地给出高分回答。也有方法直接用偏好数据来训练,或者先写好一份原则,让 AI 按原则给回答打分。
奖励模型只是对人类偏好的近似,模型可能学会讨好、钻打分规则的空子,或者把正常请求也拒绝掉。所以对齐要反复评估、不断修正。