第 5 课共 24 课 · 4 格漫画 · 课后一题
训练和推理
 GLM讲解
 Grok提问
一句话训练是“上学”,推理是“上班”;两件事都要用到大量芯片。
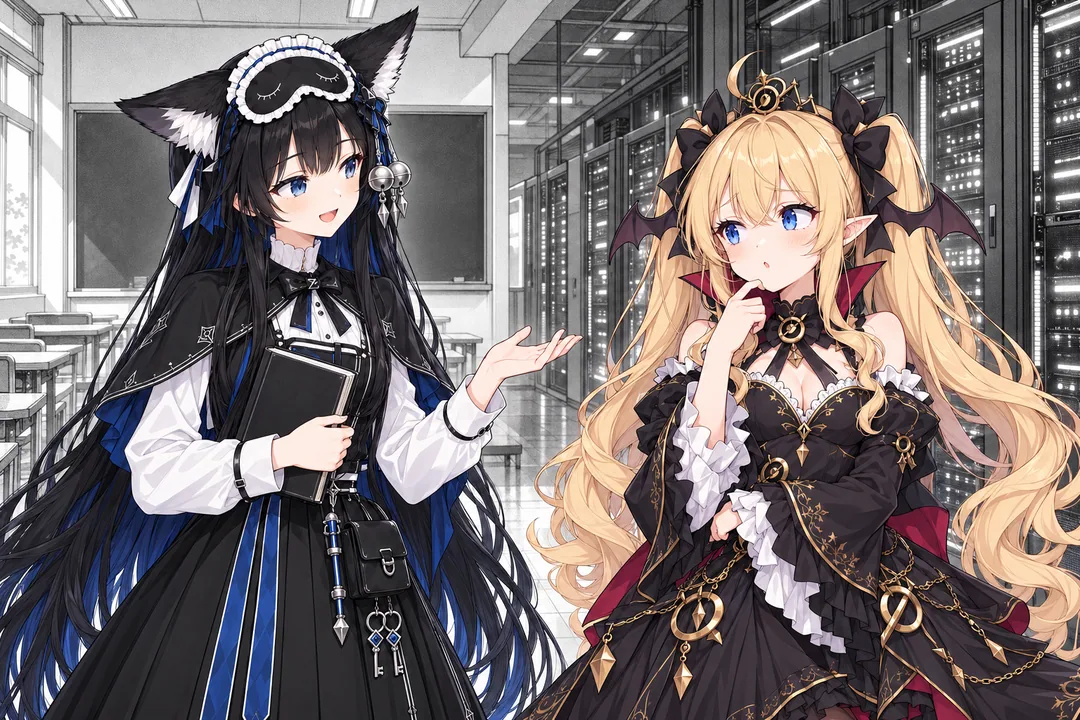
训练是让模型学习的过程:喂进大量数据,反复调整参数。最初的大规模训练叫预训练,耗时长、花费高。
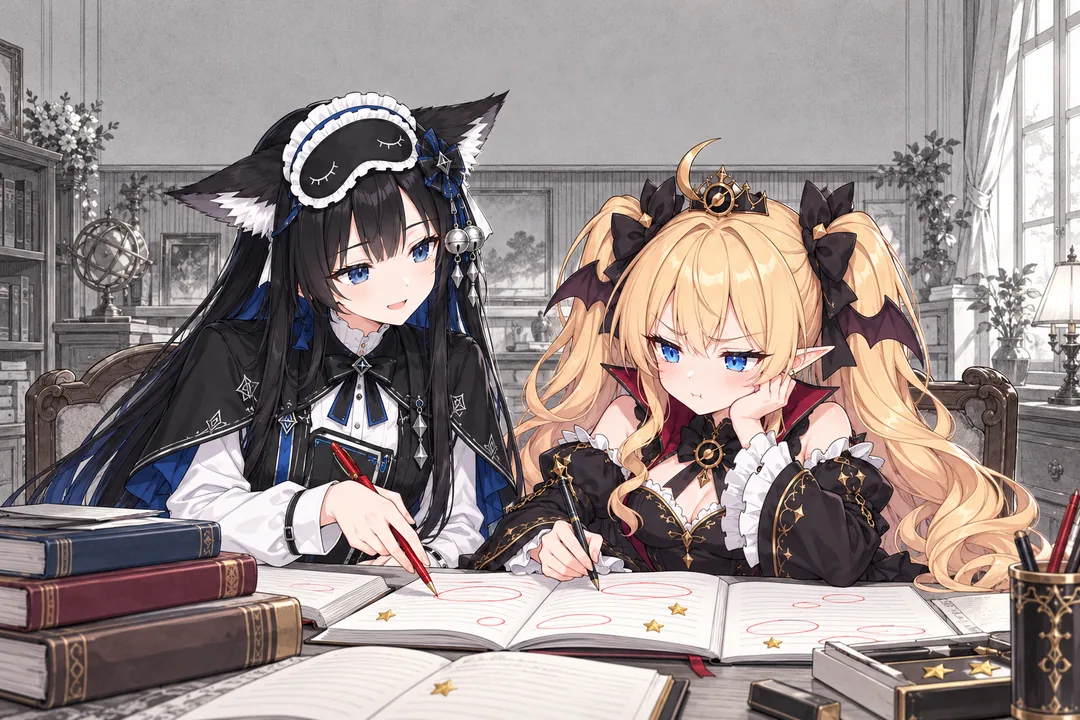
之后还有后训练:用更精挑细选的数据和人类反馈,教它听懂指令、说话得体、少犯错。针对某个用途再专门练一练,叫微调。
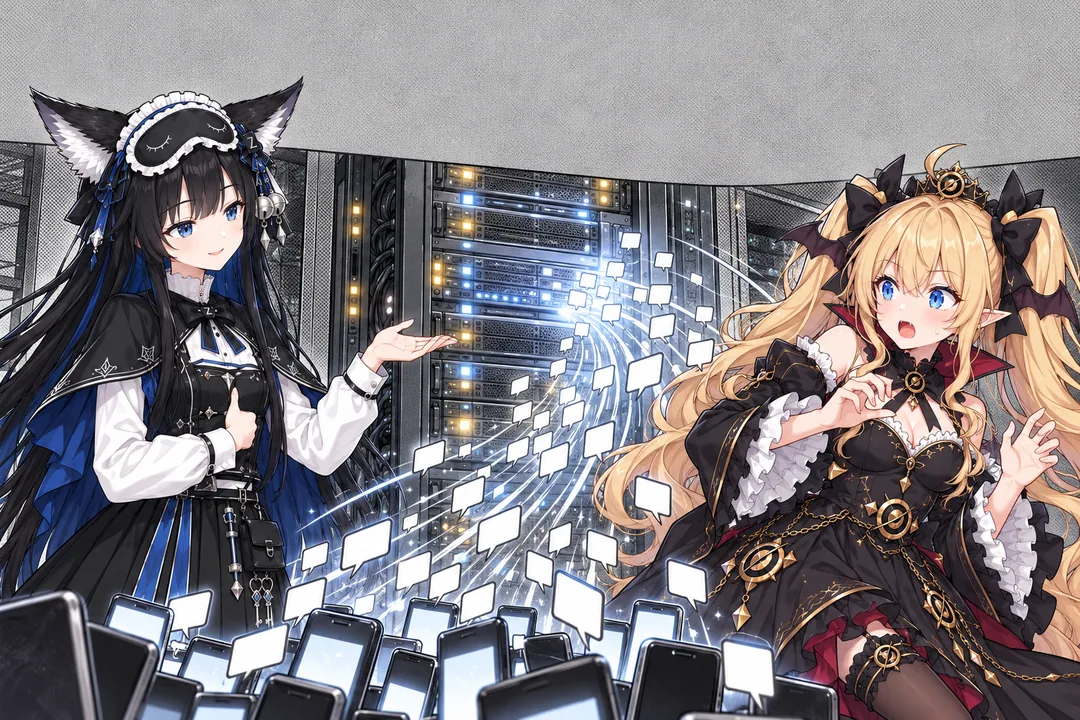
训练好的模型真正回答问题,叫推理(inference)。每有一个人提问,服务器就要算一次,用的人越多,需要的算力越多。
这两件事主要靠 GPU 等芯片完成,所以新闻里常能看到算力合同、数据中心和芯片的消息。
课后一题每天有很多人用某个模型提问,主要消耗的是哪一步的算力?
这一课的名词
- 后训练基础模型训练完成后的进一步训练,比如指令微调、强化学习,让模型更会听指令、更安全或更擅长某类任务。
- 微调在已有模型上用特定数据继续训练,让它适应某个任务或某种风格。
- 算力训练和运行 AI 需要的计算资源,通常指 GPU 等芯片能提供的总计算能力。
- GPU图形处理器,擅长同时做大量简单计算,是训练和运行大模型的主力芯片。
- 推理芯片专门用来运行(而不是训练)AI 模型的芯片,负责把用户的请求算出结果。
- 预训练训练的第一阶段:让模型读海量文字、代码等数据,学会语言和知识的基本规律,最耗算力。
- 强化学习让模型反复尝试、按结果好坏给奖励来学习的方法,常用在后训练里,让模型更会推理、更符合人的偏好。
- 推理成本模型上线后每回答一次请求要花的算力和电费。用户越多、回答越长,推理成本越高。
- 数据中心集中摆放大量服务器和芯片的机房,负责供电、散热和联网。训练和运行大模型都在这里进行。