第 4 课共 24 课 · 4 格漫画 · 课后一题
注意力机制(Transformer):模型怎么抓重点
 Grok讲解
 Seed提问
一句话读到每个词时,回头看看哪些词和它关系最大。
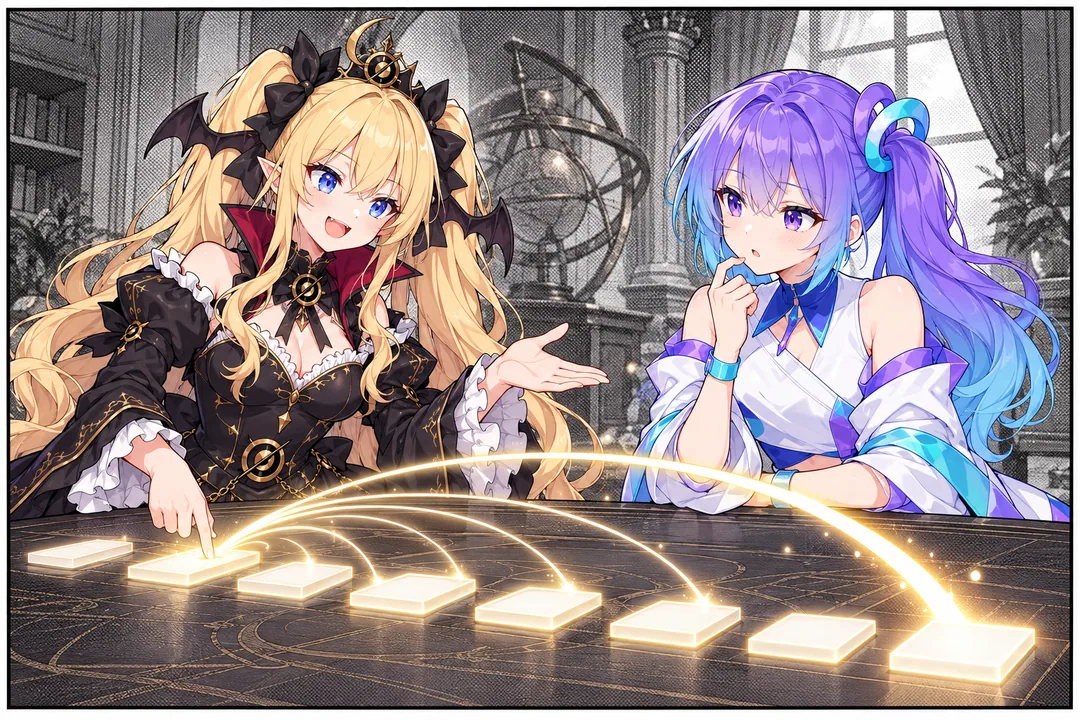
Transformer 是今天大多数大模型的基础结构,核心是注意力机制:处理每个词时,模型会回头看这段文字里的其他词,判断该重点参考哪些。
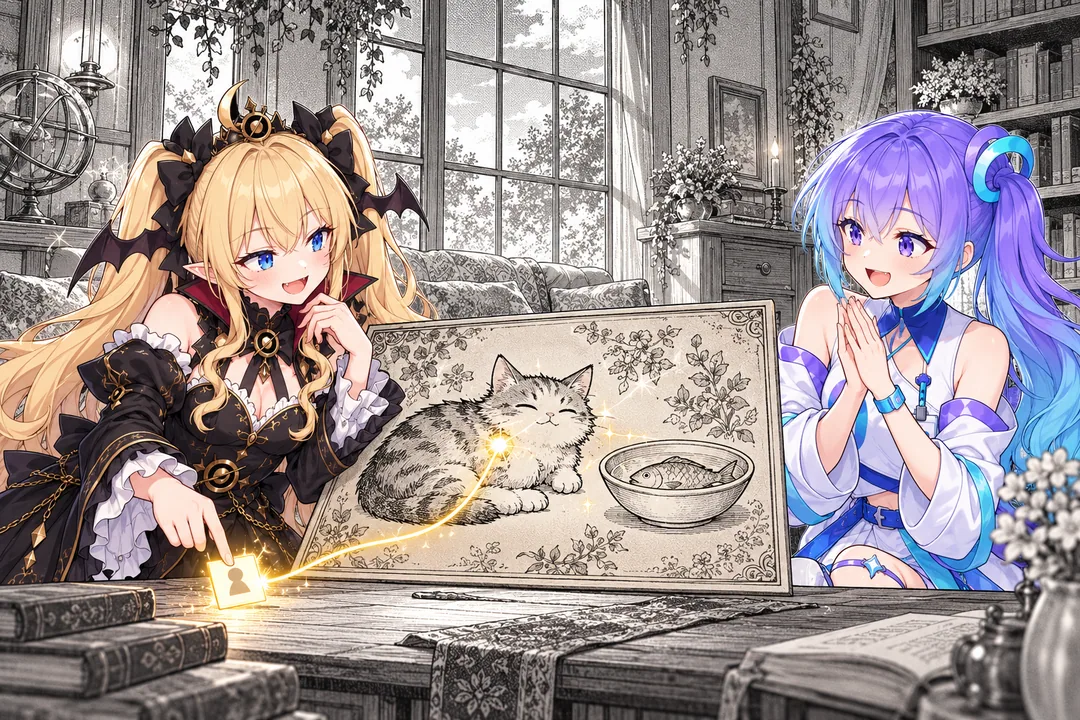
比如“猫没吃鱼,因为它不饿”:处理“它”的时候,注意力会更多地落在“猫”上,模型就能弄清指代关系。
更早的模型多半逐词往后读。Transformer 让一段话里的词同时互相“看”,很适合用 GPU 并行计算,模型才能训练得这么大。
每个词都要和其他词比一比,文字越长,计算量涨得越快,大约按长度的平方增长。这是长上下文更贵的原因之一,很多研究都在想办法省掉这部分计算。