第 3 课共 24 课 · 4 格漫画 · 课后一题
上下文:一次能看多少
 Kimi讲解
 MiMo提问
一句话上下文是模型一次能同时看到的内容,像一张书桌。
上一课说过,模型读写的是一块块 token。它一次能看到的 token 有限,聊得太久,最早的内容就可能被挪走。
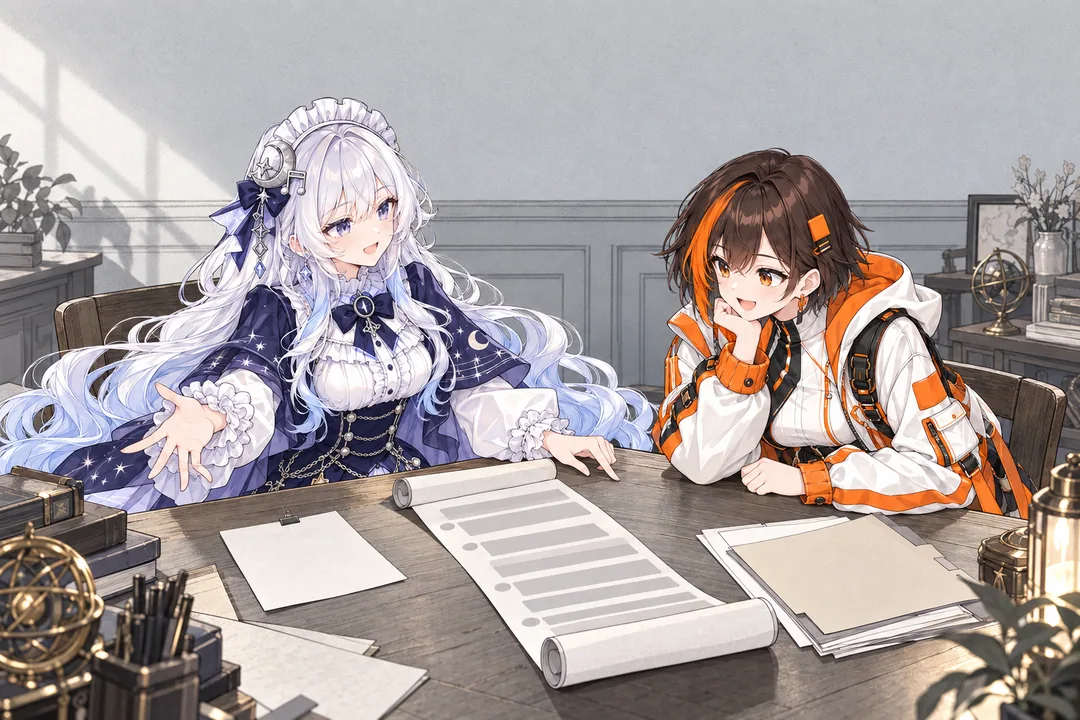
上下文是模型一次能同时看到的 token 总量,像一张书桌:你的问题、之前的对话、上传的文件,都要摆在这张桌上。
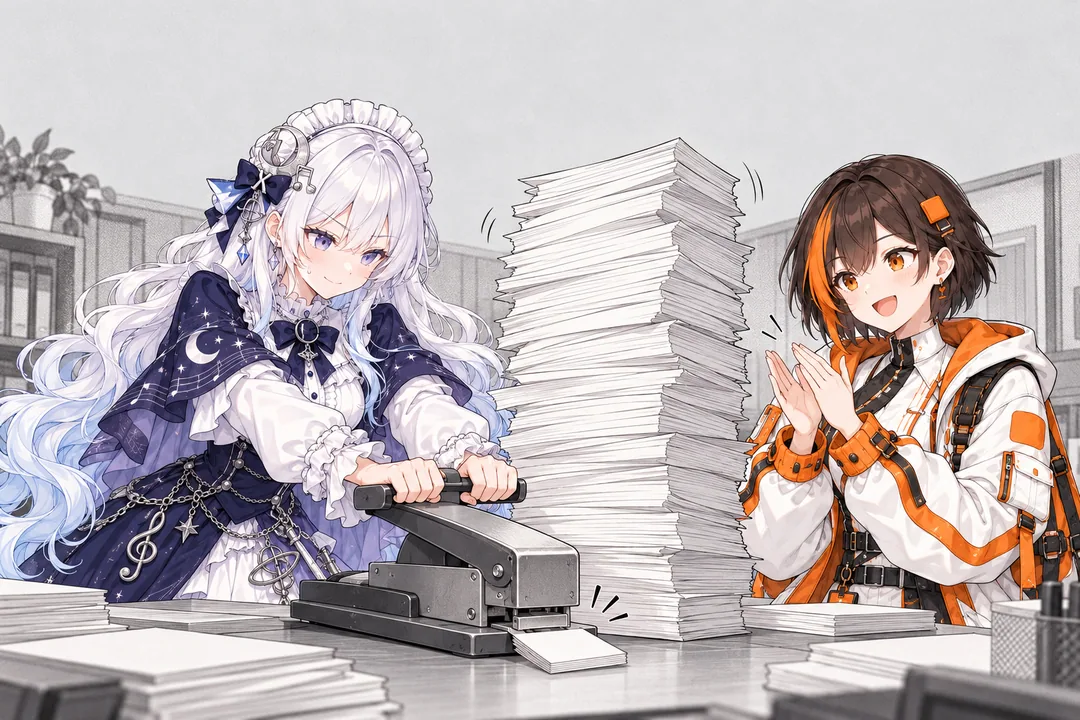
桌子越大,越能处理长文档、长对话。放不下时,要么丢掉最早的内容,要么先把旧内容总结成摘要再继续,这叫压缩。
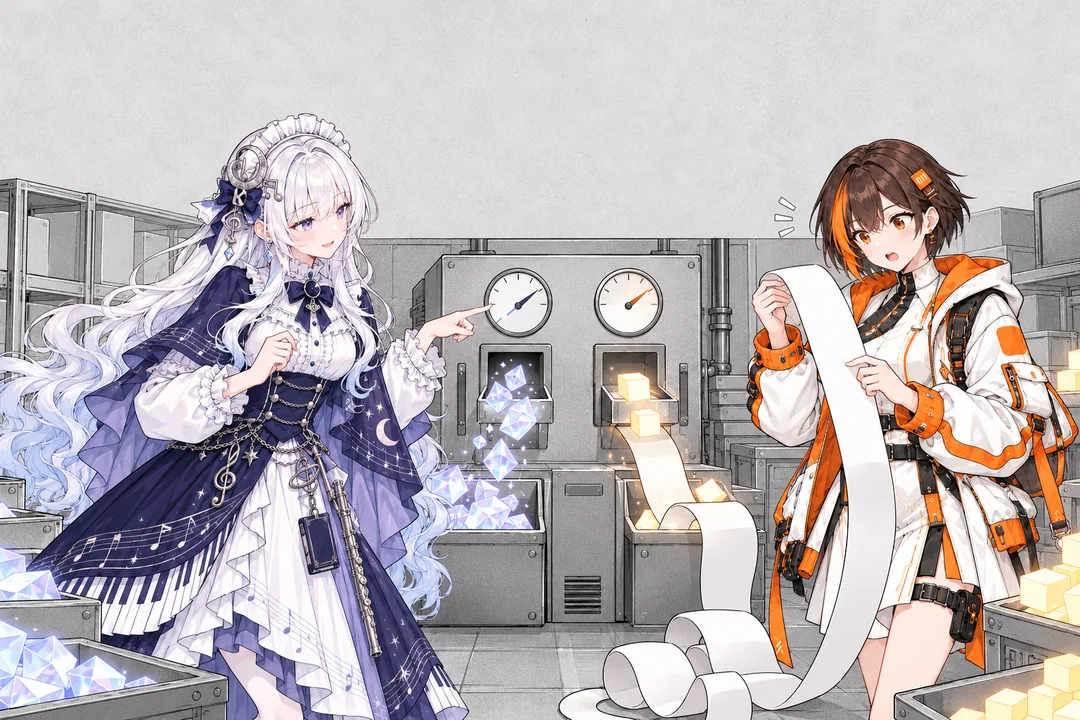
用 API 调用模型时,费用通常也按 token 计算,读进去的和写出来的分开算。
课后一题聊了很久以后,模型忘了开头说的话,最可能是因为?
这一课的名词
- token模型读写文字的计量单位,一段文字会被切成若干个 token。不同模型切法不同,上下文长度和 API 费用通常都按它计算。
- 上下文模型一次能读进来、同时参考的内容量,可以理解为它的“短期记忆”。常用 token 数衡量,例如 500k 就是 50 万个 token。
- 压缩上下文快满时,把较早的内容总结成摘要腾出空间。能继续工作,但会丢掉一部分细节。
- API开发者用程序调用模型的接口,通常按使用量(token 数)计费。
- 按 token 计费API 常见的计价方式:按处理的 token 数收费,多写成“每百万 token 多少钱”,输入和输出分开计价,输出通常更贵。
- 缓存输入重复发给模型的相同开头内容(比如长文档、固定说明)可以被缓存,再次用到时按低得多的价格计费。