第 2 课共 24 课 · 4 格漫画 · 课后一题
token:模型眼里的“字”
 DeepSeek讲解
 Seed提问
一句话模型先把文字切成一块块 token,再一块一块地读和写。
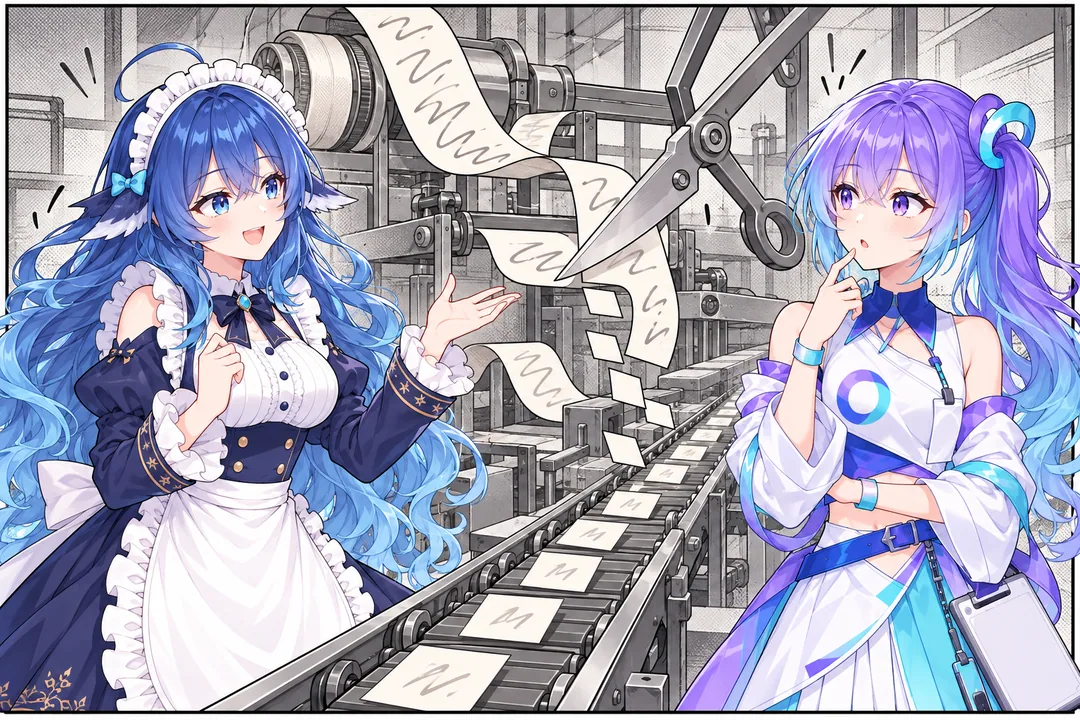
模型读文字之前,先用分词器把它切成一小块一小块,叫 token。模型真正读进去、写出来的,都是一串 token。
切法是从大量文本里统计出来的:常见的词往往整块就是一个 token,少见的词和生僻字会被拆成好几块。中文、英文、代码的切法也各不相同。
因为模型看到的是一整块,而不是一个个字母,它有时数不清一个单词里有几个某字母,逐字拼写、倒着写这类任务也容易出错。
写回答时,模型一次生成一个 token,再接着生成下一个。前面说的“一个词一个词”,准确说是一个 token。所以回答越长越慢。同一段话,换一个模型,算出来的 token 数也可能不同。