第 9 课共 24 课 · 4 格漫画 · 课后一题
混合专家(MoE):每次只叫醒几位
 DeepSeek讲解
 Nemotron提问
一句话模型里有很多位专家,每次只请其中几位来干活。
混合专家(MoE)模型里有很多组“专家”子网络。每处理一个 token,只挑其中几个专家来计算,其余的不动。
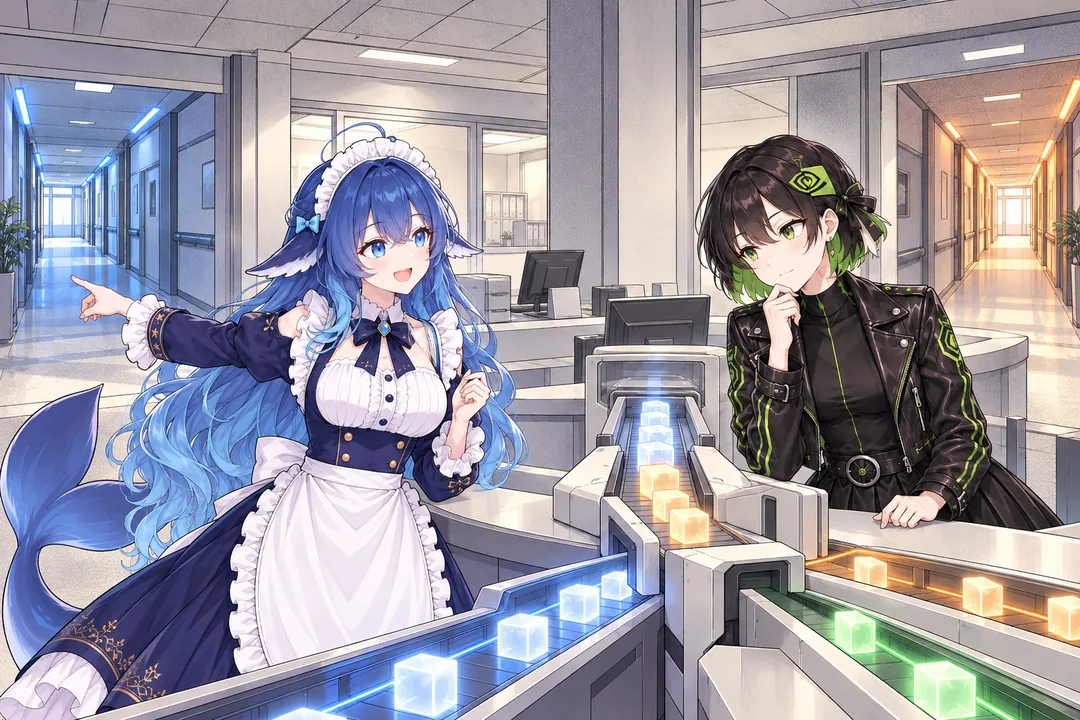
一个叫路由器的小网络会给每个 token 打分,把它派给最合适的几位专家。相邻的两个 token 也可能被派到不同的专家那里。
所以 MoE 模型常报两个数:总参数是所有专家加起来,激活参数是每个 token 实际用到的那部分。算得少,推理就更快、更省。
代价是所有专家都得放进内存,占用按总参数算,不按激活参数算。训练时还要让活儿在专家之间分得均匀,别让少数几位累坏。